/6 分钟/3 阅读/0 评论
连接池
概念:其实就是一个容器(集合),存放数据库连接的容器。 当系统初始化好后,容器被创建,容器中会申请一些连接对象,当用户来访问数据库时,从容器中获取连接对象,用户访问完之后,会将连接对象归还给容器。 缺点:用户每次请求都需要向数据库获得链接,
连接池概念
概念:其实就是一个容器(集合),存放数据库连接的容器。
当系统初始化好后,容器被创建,容器中会申请一些连接对象,当用户来访问数据库时,从容器中获取连接对象,用户访问完之后,会将连接对象归还给容器。
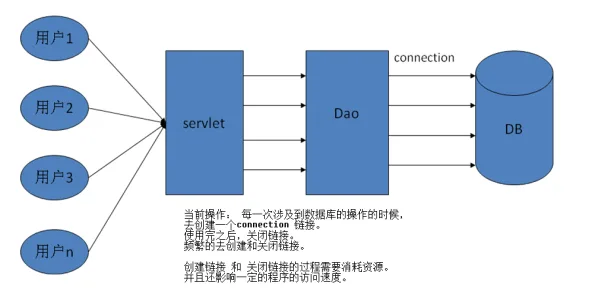
缺点:用户每次请求都需要向数据库获得链接,而数据库创建连接通常需要消耗相对较大的资源,创建时间也较长。假设网站一天10万访问量,数据库服务器就需要创建10万次连接,极大的浪费数据库的资源,并且极易造成数据库服务器内存溢出。
连接池技术的核心思想是:连接复用,通过建立一个数据库连接池以及一套连接使用、分配、管理策略,使得该连接池中的连接可以得到高效、安全的复用,避免了数据库连接频繁建立、关闭的开销。
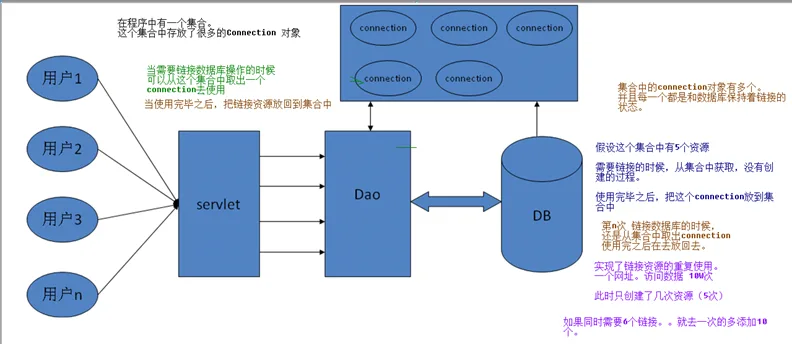
连接池好处
1. 节约资源
	2. 减少连接db的次数
	3. 用户访问高效
连接池实现
1. 标准接口:DataSource   javax.sql包下的
1. 方法:
	* 获取连接:getConnection()
	* 归还连接:Connection.close()。如果连接对象Connection是从连接池中获取的,那么调用Connection.close()方法,则不会再关闭连接了。而是归还连接
厂商实现
一般我们不去实现它,有数据库厂商来实现
	1. C3P0:数据库连接池技术
	2. Druid:数据库连接池实现技术,由阿里巴巴提供的
c3p0数据库连接池
实现步骤
1. 导入jar包  c3p0-0.9.5.2.jar  mchange-commons-java-0.2.12.jar(可以不导)
新建web项目 C3p0Test
使用c3p0的连接池,导入jar包
导入 mysql驱动包

2. 定义配置文件:
名称: c3p0.properties 或者 c3p0-config.xml
路径:直接将文件放在src目录下即可。

3. 创建核心对象 数据库连接池对象 ComboPooledDataSource

4. 获取连接: getConnection
代码:
//1.创建数据库连接池对象
DataSource ds  = new ComboPooledDataSource();
//2. 获取连接对象
Connection conn = ds.getConnection();
工具类的抽取
package cn.yanqi.utils;

import java.sql.Connection;

import java.sql.ResultSet;
import java.sql.SQLException;
import java.sql.Statement;

import com.mchange.v2.c3p0.ComboPooledDataSource;
// 你抽出的代码要有一定意义,并且要有通用性,任何一个关于这个工具类都 可以去使
public class JdbcUtils {
    //默认加载src 下面c3p0-config.xml加载
    private static ComboPooledDataSource ds = new ComboPooledDataSource();

    //创建连接
    public static Connection getConnection() throws SQLException{
        return ds.getConnection();
    }

    public static void close(Connection conn,Statement stmt){
        try {
            if(stmt != null){
                stmt.close();
                stmt=null;//gc 一个变量被赋值为null, 垃圾回收机制。 会优先处理这些对象。
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
        try {
            if(conn != null){
                conn.close();
                conn=null;//gc 一个变量被赋值为null, 垃圾回收机制。 会优先处理这些对象。
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }

    public static void close(Connection conn,Statement stmt,ResultSet rs){
        //6.关闭连接(后打开的先关闭)
        try {
            if(rs != null){
                rs.close();
                rs=null;//gc   一个变量被赋值为null, 垃圾回收机制。 会优先处理这些对象。
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
        try {
            if(stmt != null){
                stmt.close();
                stmt=null;//gc 一个变量被赋值为null, 垃圾回收机制。 会优先处理这些对象。
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
        try {
            if(conn != null){
                conn.close();
                conn=null;//gc 一个变量被赋值为null, 垃圾回收机制。 会优先处理这些对象。
            }
        } catch (SQLException e) {
            e.printStackTrace();
        }
    }
}
配置文件
c3p0-config.xml 注意一定放在src下
<?xml version="1.0" encoding="UTF-8"?>
<c3p0-config>
    <!-- 我们希望在配置文件中,出现链接的参数信息 -->
    <default-config>
        <!-- name 属性定义 链接参数的key 标签的内容 代表值-->
        <property name="driverClass">com.mysql.jdbc.Driver</property>
        <property name="jdbcUrl">jdbc:mysql:///day03</property>
        <property name="user">root</property>
        <property name="password">root</property>

		<!-- 连接池参数 -->
		<property name="initialPoolSize">5</property>
        <property name="maxPoolSize">10</property>
        <property name="checkoutTimeout">3000</property>

    </default-config>
</c3p0-config>
测试
@Test
public void test1() throws SQLException {

    //封装的c3p0相关代码
    Connection conn = JdbcUtil.getConnection();

    Statement stmt = conn.createStatement();

    int i = stmt.executeUpdate("delete from user where id = 29");
    System.out.println(i);

    JdbcUtil.close(conn,stmt);

}
Druid数据库连接池
Druid数据库连接池实现技术,由阿里巴巴提供的
实现步骤
一、步骤:
	1. 导入jar包 druid-1.0.9.jar
	2. 定义配置文件:
		是xx.properties形式的
		可以叫任意名称,可以放在任意目录下, 一般都放在src
	3. 加载配置文件。Properties
	4. 获取数据库连接池对象:通过工厂来来获取  DruidDataSourceFactory
	5. 获取连接:getConnection

	代码实现:
		//3.加载配置文件
	     Properties pro = new Properties();
	     InputStream is = 		       DruidDemo.class.getClassLoader().getResourceAsStream("druid.properties");
	     pro.load(is);
	     //4.获取连接池对象
	     DataSource ds = DruidDataSourceFactory.createDataSource(pro);
	     //5.获取连接
	     Connection conn = ds.getConnection();
二、定义工具类
		1. 定义一个类 JDBCUtils
		2. 提供静态代码块加载配置文件,初始化连接池对象
		3. 提供方法
			1. 获取连接方法:通过数据库连接池获取连接
			2. 释放资源
			3. 获取连接池的方法
配置文件
在src中创建 druid.properties
driverClassName=com.mysql.jdbc.Driver
url=jdbc:mysql:///db3
username=root
password=root
# 初始化连接数量
initialSize=5
# 最大连接数
maxActive=10
# 最大等待时间
maxWait=3000
工具类的抽取
import java.io.IOException;
import java.sql.ResultSet;
import java.sql.SQLException;

/**
 * Druid连接池的工具类
 */
public class JDBCUtils {

    //1.定义成员变量 DataSource
    private static DataSource ds ;

    static{
        try {
            //1.加载配置文件
            Properties pro = new Properties();
            pro.load(JDBCUtils.class.getClassLoader().getResourceAsStream("druid.properties"));
            //2.获取DataSource
            ds = DruidDataSourceFactory.createDataSource(pro);
        } catch (IOException e) {
            e.printStackTrace();
        } catch (Exception e) {
            e.printStackTrace();
        }
    }

    /**
     * 获取连接
     */
    public static Connection getConnection() throws SQLException {
        return ds.getConnection();
    }

    /**
     * 释放资源
     */
    public static void close(Statement stmt,Connection conn){
             close(null,stmt,conn);
    }

    public static void close(ResultSet rs , Statement stmt, Connection conn){

        if(rs != null){
            try {
                rs.close();
            } catch (SQLException e) {
                e.printStackTrace();
            }
        }

        if(stmt != null){
            try {
                stmt.close();
            } catch (SQLException e) {
                e.printStackTrace();
            }
        }

        if(conn != null){
            try {
                conn.close();//归还连接
            } catch (SQLException e) {
                e.printStackTrace();
            }
        }
    }

    /**
     * 获取连接池方法
     */
    public static DataSource getDataSource(){
        return  ds;
    }
}
测试
JDBCTemplate模版
概述
Spring JDBC Spring框架对JDBC的简单封装。提供了一个JDBCTemplate对象简化JDBC的开发(后面我们专门讲spring框架
实现步骤
1. 导入jar包 4 + 1

2. 创建JdbcTemplate对象。依赖于数据源DataSource
	JdbcTemplate template = new JdbcTemplate(ds);

3. 调用JdbcTemplate的方法来完成CRUD的操作
	update():执行DML语句。增、删、改语句
	queryForMap():查询结果将结果集封装为map集合,将列名作为key,将值作为value 将这条记录封装为一个map集合
			注意:这个方法查询的结果集长度只能是1
	queryForList():查询结果将结果集封装为list集合
			注意:将每一条记录封装为一个Map集合,再将Map集合装载到List集合中
	query():查询结果,将结果封装为JavaBean对象
			query的参数:RowMapper
			一般我们使用BeanPropertyRowMapper实现类。可以完成数据到JavaBean的自动封装
			new BeanPropertyRowMapper<类型>(类型.class)
			queryForObject:查询结果,将结果封装为对象
			一般用于聚合函数的查询
快速入门
/**
 * JdbcTemplate入门
 */
public class JdbcTemplateDemo1 {

    public static void main(String[] args) {
        //1.导入jar包
        //2.创建JDBCTemplate对象
        JdbcTemplate template = new JdbcTemplate(JDBCUtils.getDataSource());
        //3.调用方法
        String sql = "update account set balance = 5000 where id = ?";
        int count = template.update(sql, 3);//insert update delete
        System.out.println(count);
        //自已关闭,自已归还
    }
}
CRUD的测试
代码实现
实体类
public class Emp {
    private Integer id;
    private String ename;
    private Integer job_id;
    private Integer mgr;
    private Date joindate;
    private Double salary;
    private Double bonus;
    private Integer dept_id;
    //提供有参无对构造方法
    //提供get  set 方法
    //提供toString方法
}
测试类
public class Test1 {

    //获取数据源
    private DataSource dataSource = JDBCUtil.getDataSource();
    //使用jdbcTemplate 技术,简化jdbc操作
    private JdbcTemplate JdbcTemplate = new JdbcTemplate(dataSource);

    //修改
    @Test
    public void testUpdateById(){
        String sql ="update emp set job = '财务' where id = ? ";
        int i = this.JdbcTemplate.update(sql, 2);
        System.out.println(i);
    }

    //添加
    @Test
    public void testAdd(){
        String sql ="insert into emp (id , username , job ,addr) values(?,?,?,?)";
        int i = JdbcTemplate.update(sql, null, "yiyan", "小秘", "郑州");
        System.out.println(i);
    }
    //删除
    @Test
    public void testDeleteById(){
        String sql ="delete from emp where id = ?";
        int i = JdbcTemplate.update(sql, 1);
        System.out.println(i);
    }

    //查询数据返回list
    @Test
    public void testQueryById(){
        String sql ="select * from emp where id = ?";
        //返回的是list
        List<Emp> emps = this.JdbcTemplate.query(sql, new BeanPropertyRowMapper<Emp>(Emp.class), 2);
        for(Emp e : emps){
            System.out.println(e);
        }
    }

    //查询条数
    @Test
    public void testForObject(){
        String sql = "select count(1) from emp";
        Long i = this.JdbcTemplate.queryForObject(sql, Long.class);
        System.out.println(i);
    }

    //查询数据返回map
    @Test
    public void testQuery2(){
        String sql = "select * from emp where id = ?";
        //返回map
        Map<String, Object> map = this.JdbcTemplate.queryForMap(sql,2);
        //map遍历
        Set<String> set = map.keySet();
        for(String key : set){
            Object o = map.get(key);
            System.out.println(key+" : "+o);
        }
    }
}