老王 AI 工作流:七张图与两段思考
七张流程图配讲解提示,适合投屏或插入 PPT
老王 AI 工作流:七张图与两段思考
图片为 1920 × 1080 PNG,适合投屏或插入 PPT;同名 SVG 保留可编辑文字。
这是我的个人使用经验整理,完整案例见主文档。
配套:真实对话与来源。对话为历史记录的简化转述。
🎬 开篇:我们的一天,时间都去哪了
一句话:开发的时间大半不花在写代码上,而是花在梳理需求、摸清代码、查数据、写文档、排查定位上。
| 最费时间的环节 | 以前 | 现在 |
|---|---|---|
| 🧩 梳理需求 | 散在 PRD、原型和口头讨论里,靠反复问 | grill-me 五维度问清,落成 01 需求分析 |
| 🗺️ 梳理代码结构 | 接手老功能靠记忆,翻半天才知道链路 | 抓包 + 链路定位,出 02 代码库全景 |
| 🗄️ 查数据 | 反复写 SQL 试 | AI 出只读 SQL,我执行后回传 |
| 📄 写交付文档 | 手写 4—8 小时 | 按模板生成,我复核事实 |
| 🐛 排查定位 | 靠经验猜 | 日志 + 代码 + 数据交叉验证 |
AI 提效的本质,是把自己的工作模式沉淀成一套流程:繁琐耗时的交给 AI,重点决策留给自己。
但 AI 得先“敢质疑、讲证据、对交付较真”才真帮得上忙——所以我给搭档设了“老王”人设:😤 需求不清直接喷、🔨 编译不过继续修、🤝 先给结论再给依据。
对话 D1|先让老王质疑需求(Claude Code,简化整理)
**我:**针对这个 PRD,帮我看看还有哪些不清晰的地方。
**老王:**PRD 里两个范围选择器长得一样,它们是否联动?数值为 0 和尚未产生数据,应该怎么区分?
**提效技巧:**主动要求它找歧义,把讨论推进到业务口径和边界条件。
对应 Skill:grill-me,连续追问目标、边界、异常和验收标准。 来源 D1
1. 我的一天:让 AI 真正帮上忙
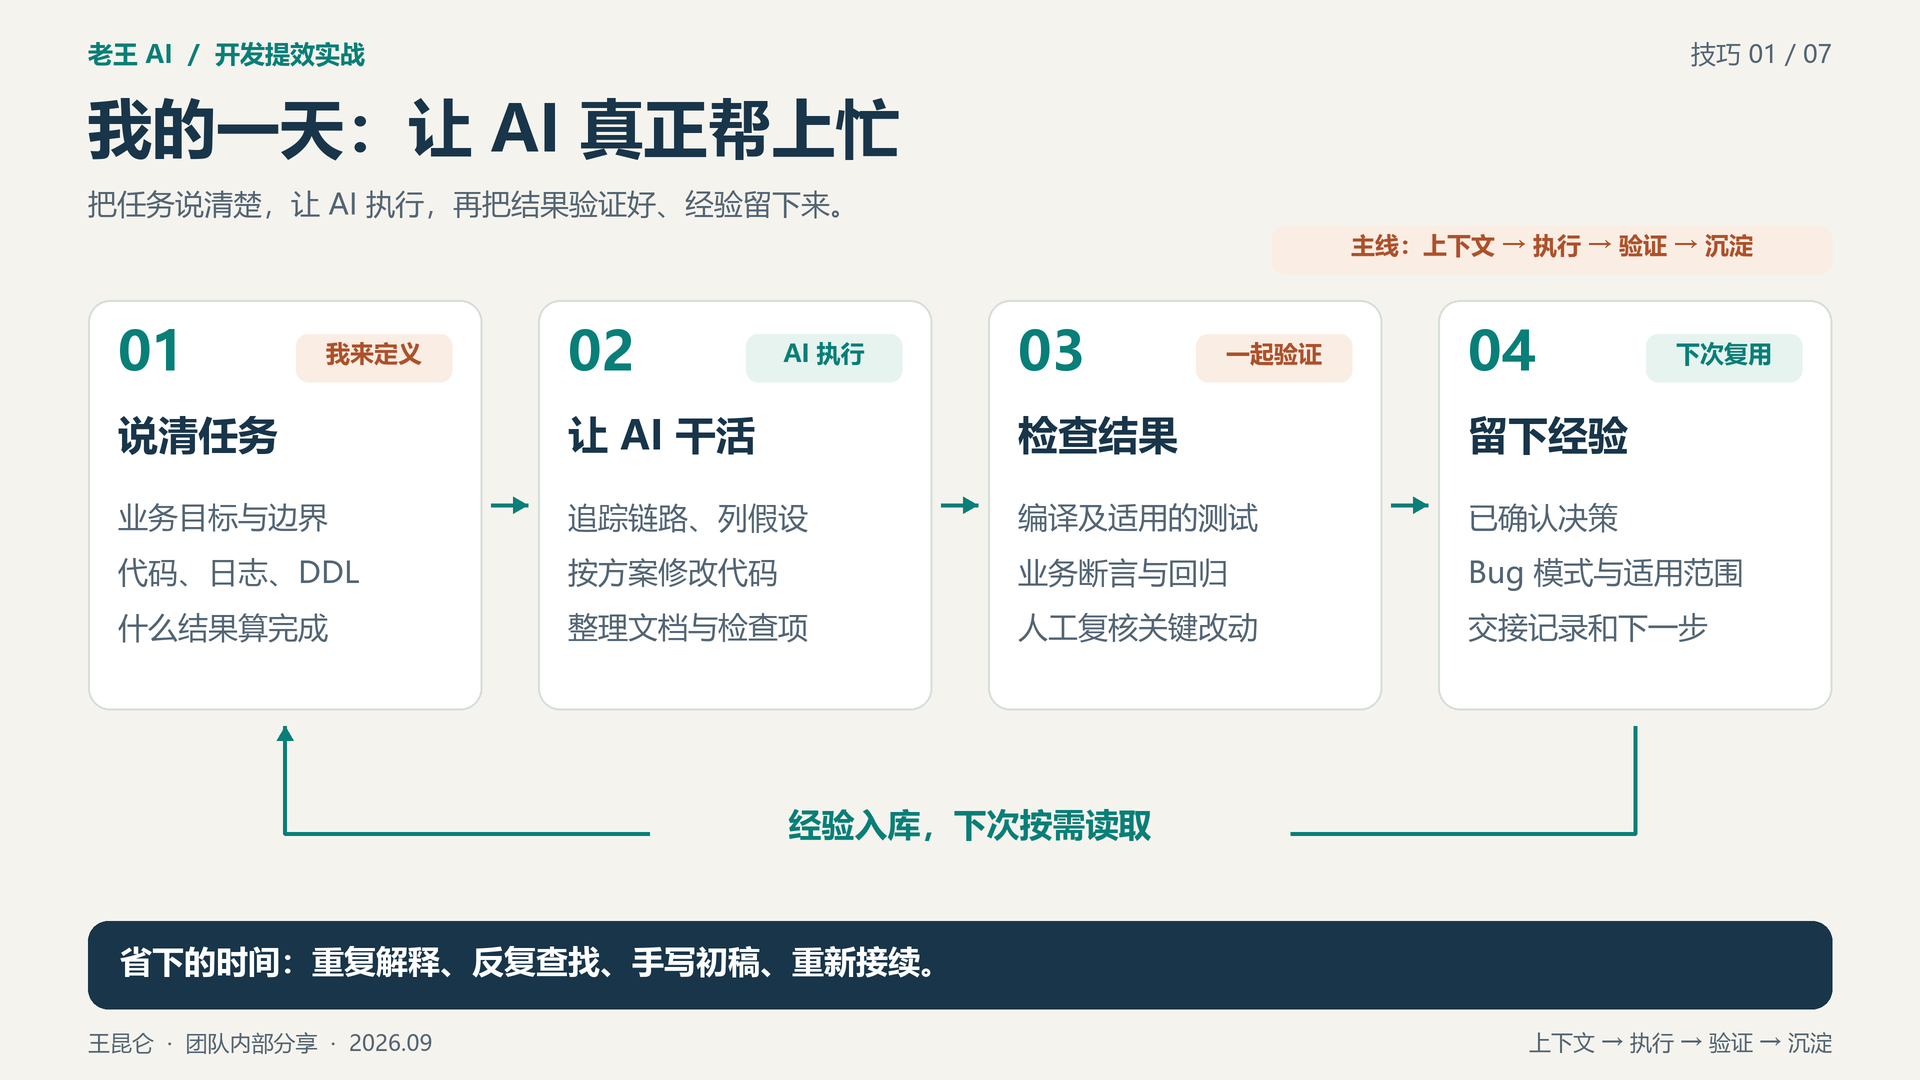
**讲解提示:**开场先讲“时间都去哪了”:找代码、补背景、查数据、写文档最耗时;再指着四步讲我先说清任务、AI 查和写、我检查结果、最后留下经验。

对话 D3|迁移时把改动边界说清楚(Codex,简化整理)
**我:**调用方接口不改;服务端读取最新数据,合并本次修改,再把完整结果传给下游。
**老王:**明白。新增是追加,修改是替换,删除是移除;我会保持接口不变,只调整服务端组装逻辑。
**提效技巧:**业务边界由人明确,AI 再把新增、修改、删除的差异展开。 来源
对应 Skill:doc-tech-solution → tech-solution-review → project-utils → code-review-skill-main/business——先写方案,编码前挑刺评审,再约束实现,最后做工程质量与业务逻辑双重审查。
2. 我的提问习惯:一次给齐四类信息
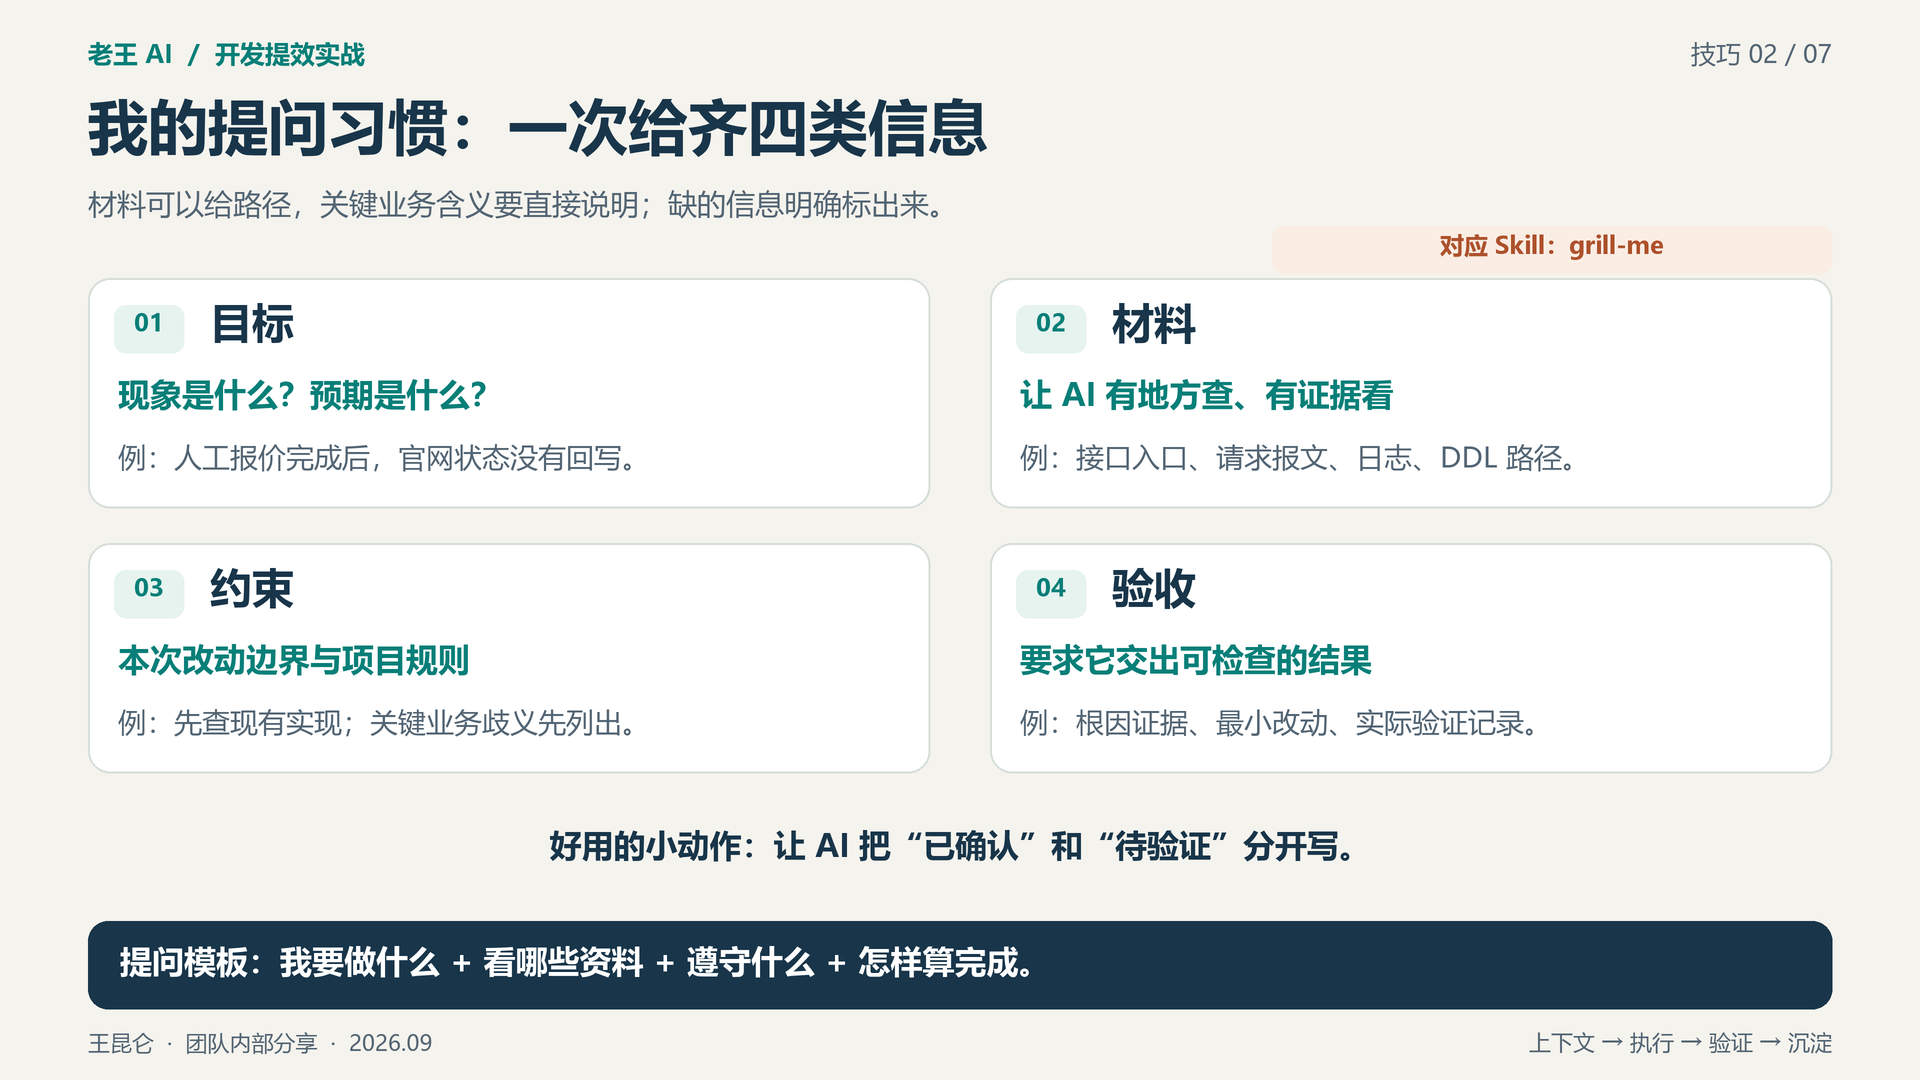
**讲解提示:**用“人工报价状态没回写”举例:我会一次给齐目标、材料、约束、验收,再让 AI 分开写已确认事实和待验证假设。

3. 排查 Bug:每个结论都要有证据
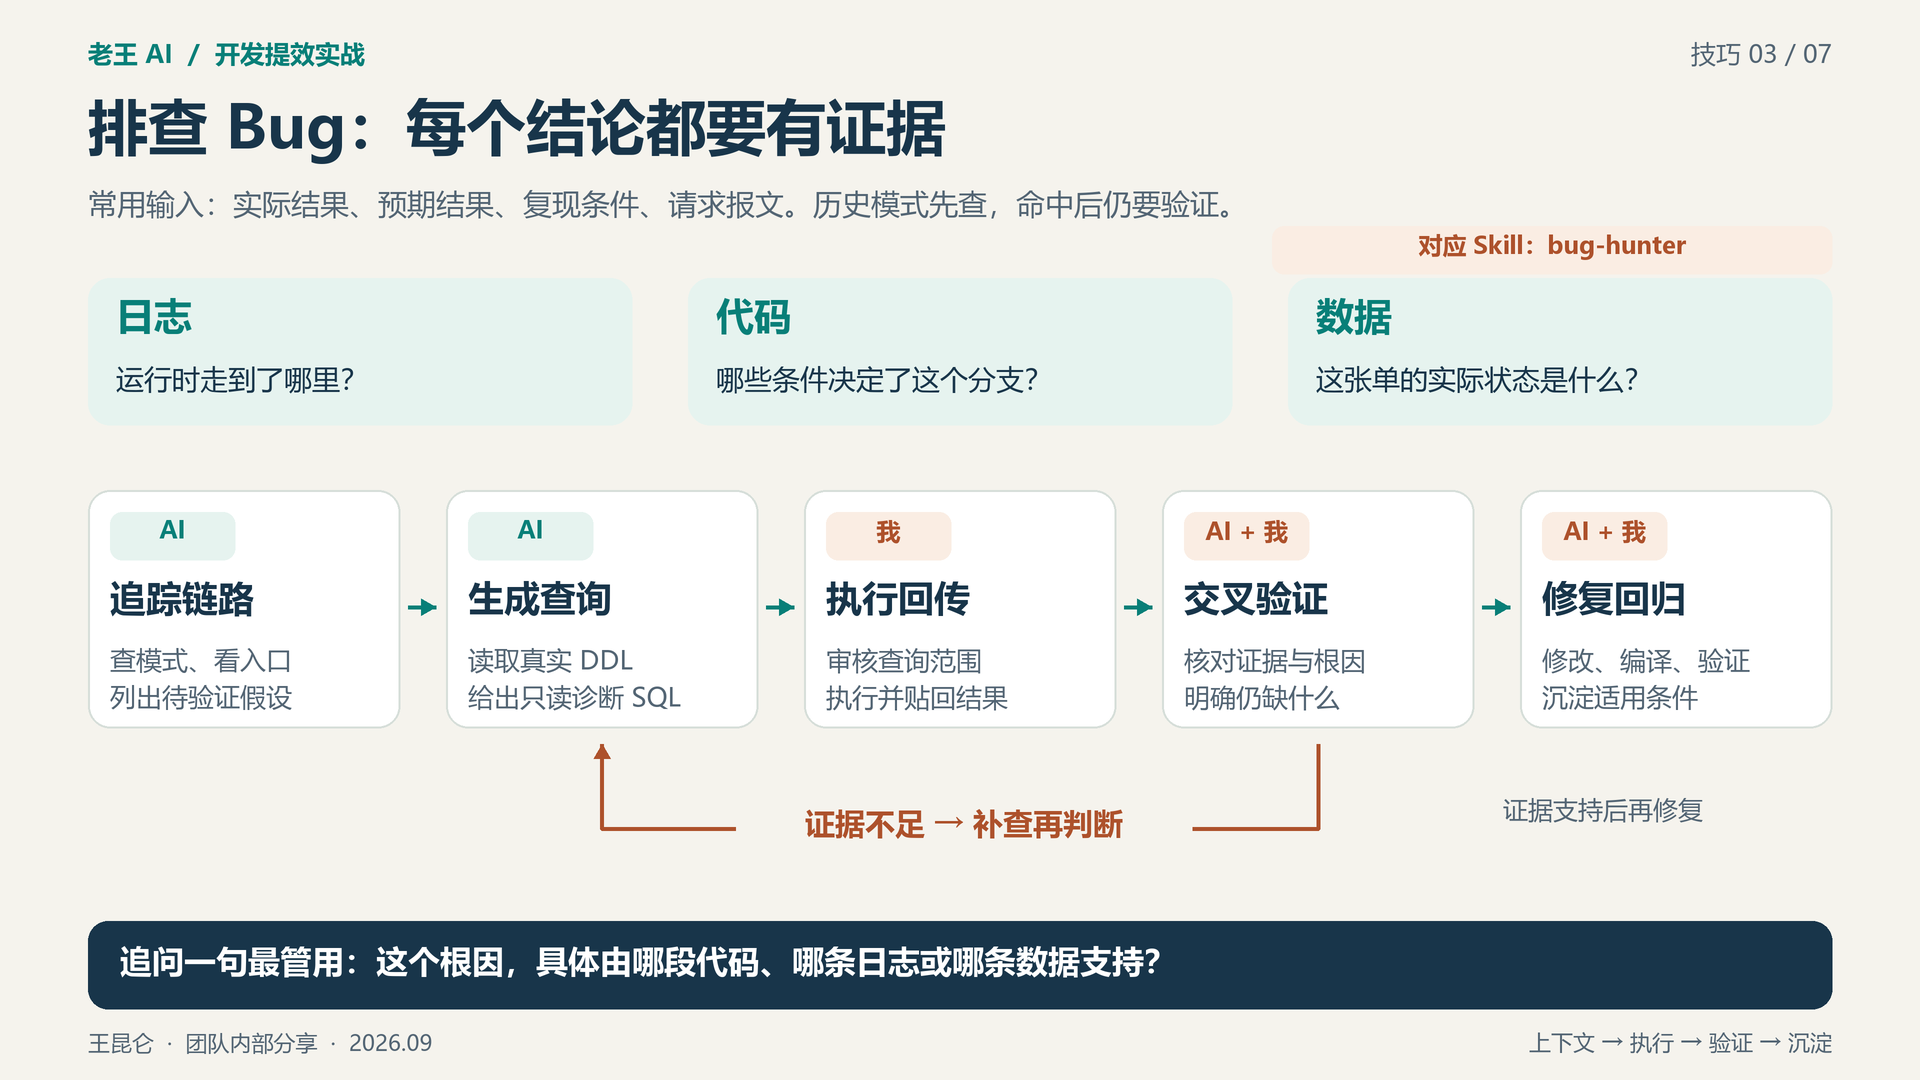
**讲解提示:**先讲上面三类证据,再沿着下面箭头讲我和 AI 怎么配合。重点停在回路:证据不足就补查,支持根因后再修复。

对话 D2|让查询结果纠正初步判断(Claude Code,简化整理)
**我:**我把两张关联表的查询结果贴回来了:原先怀疑的金额其实一致,但类型和成本字段不同。
**老王:**收到,金额假设被数据推翻;真正差异是类型和成本。接下来只追这两个字段的赋值链路。
**提效技巧:**把查询结果贴回来,允许证据推翻最初的排查假设。 来源
对应 Skill:bug-hunter——串起日志、代码、数据三类证据。
4. 少重复解释:规则、知识、流程分开存
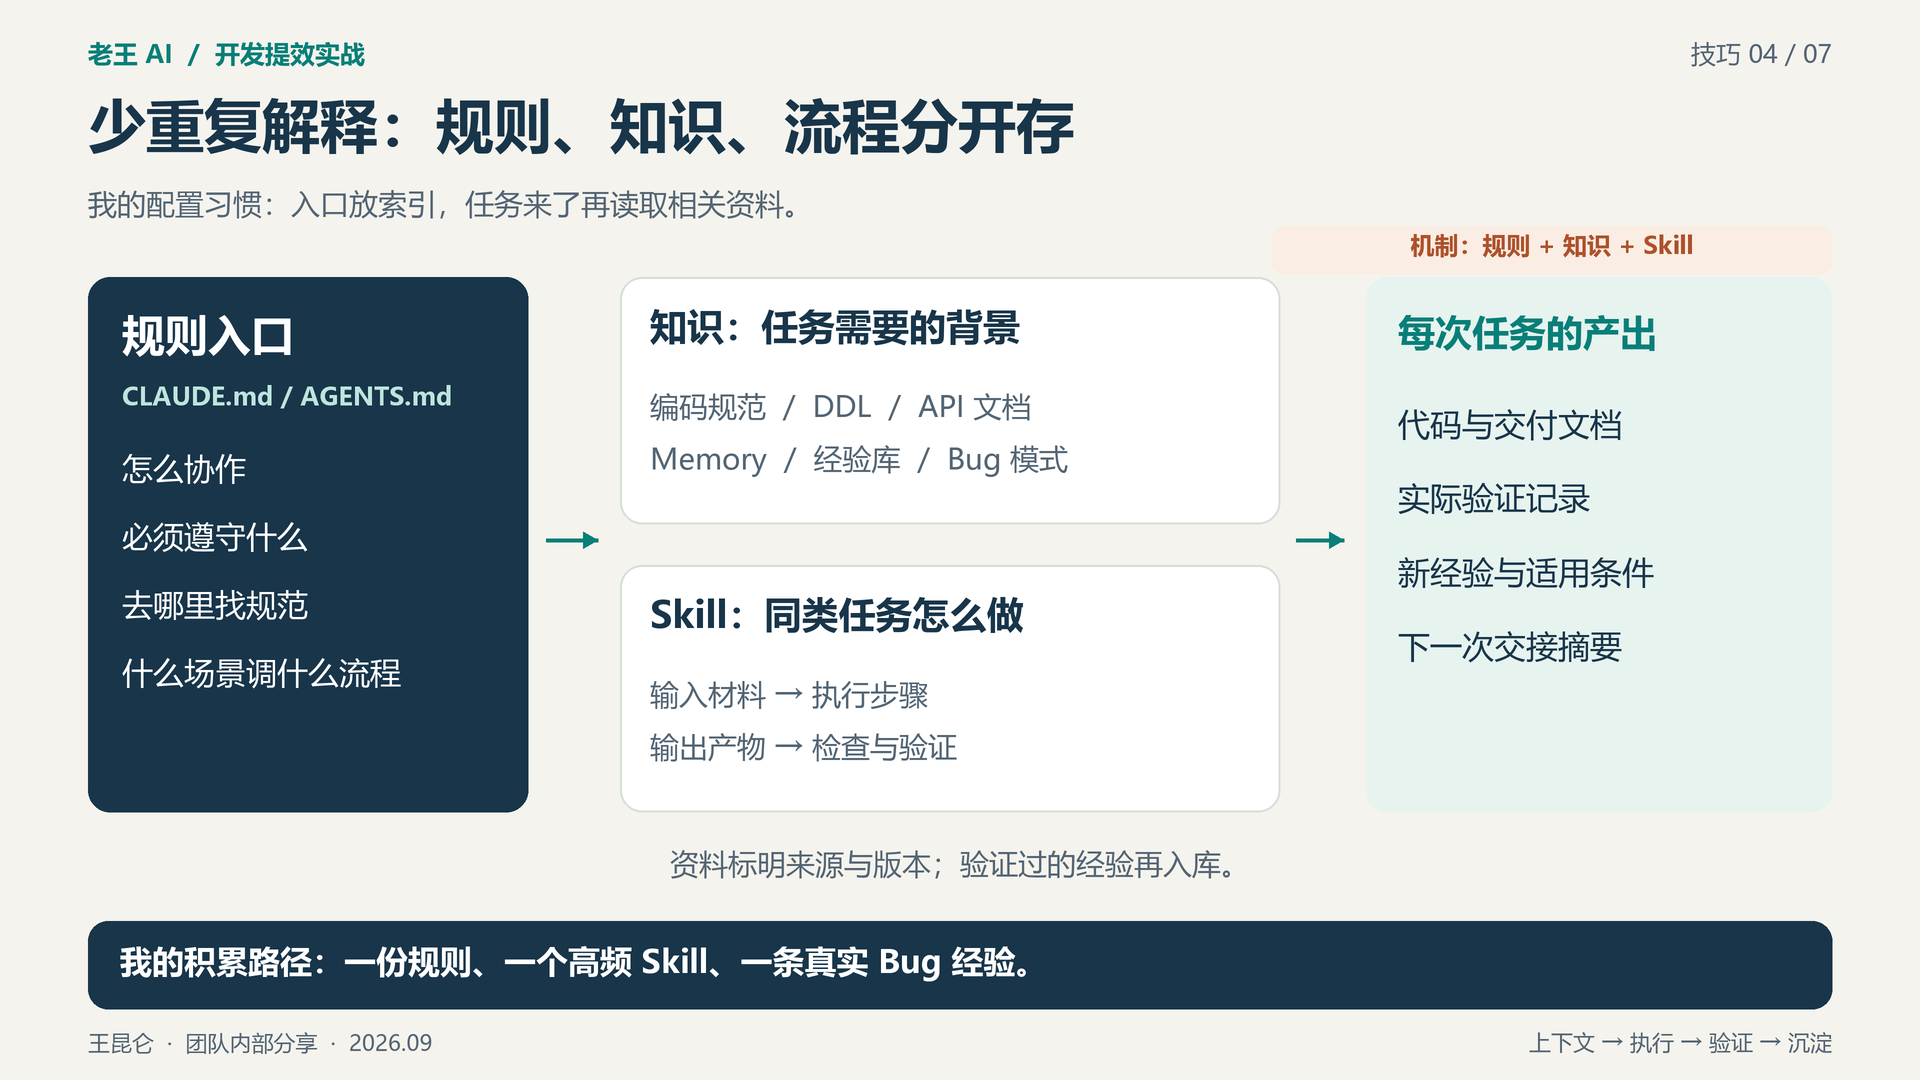
**讲解提示:**我把常用要求放在入口,把业务资料放进知识文件,把高频操作做成 Skill。任务来了按需读取,验证过的经验继续积累。

对话 D5|拿接口文档纠正状态映射(Claude Code,简化整理)
**我(先问):**本地这个状态能不能映射成对方的“已取消”?
**我(核对后):**我重新对照了 API 文档,里面没有这个状态码,该怎么处理?
**提效技巧:**对照外部契约复核 AI 产物,发现不支持的状态就重新讨论。 来源
对应 Skill:api-integration——整理字段、枚举、异常重试和联调检查项。
5. 同一份上下文,分阶段交付四份文档
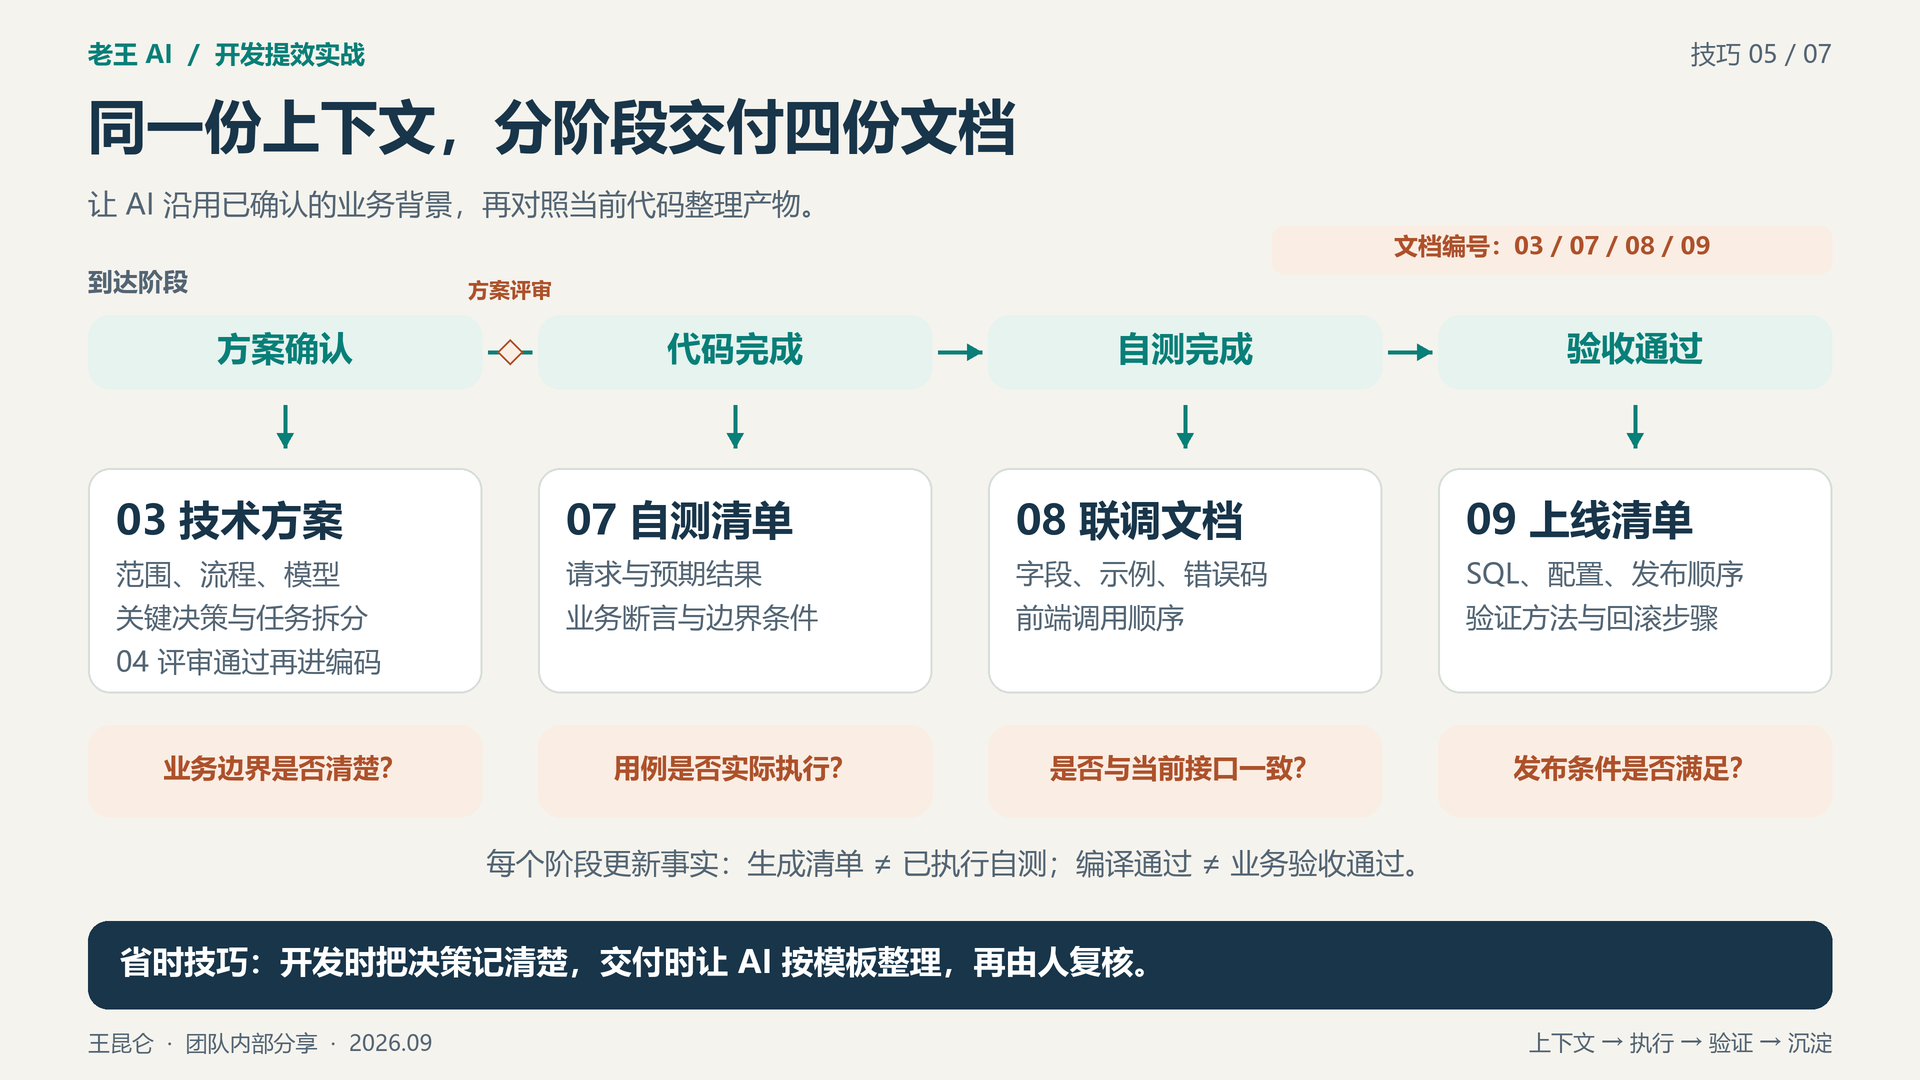
**讲解提示:**03 技术方案、07 自测清单、08 联调文档、09 上线清单,都能沿用已有业务背景;方案先过 04 评审关,其余等对应阶段完成,再对照当前代码更新事实。

对话 D4|用真实环境数据生成自测清单(Codex,简化整理)
**我:**查询结果贴回来了,其中两条 SQL 没有查到数据。
**老王:**不编造测试参数。已有数据直接复用,空数据标为前置条件;能由前序步骤产生的数据,放到后面验证。
**提效技巧:**先补测试数据,再生成按业务顺序可执行的清单。 来源
对应 Skill:doc-self-test-checklist——按实际代码和数据编排可执行用例。
6. 换会话、换 agent:先交接,再接着干
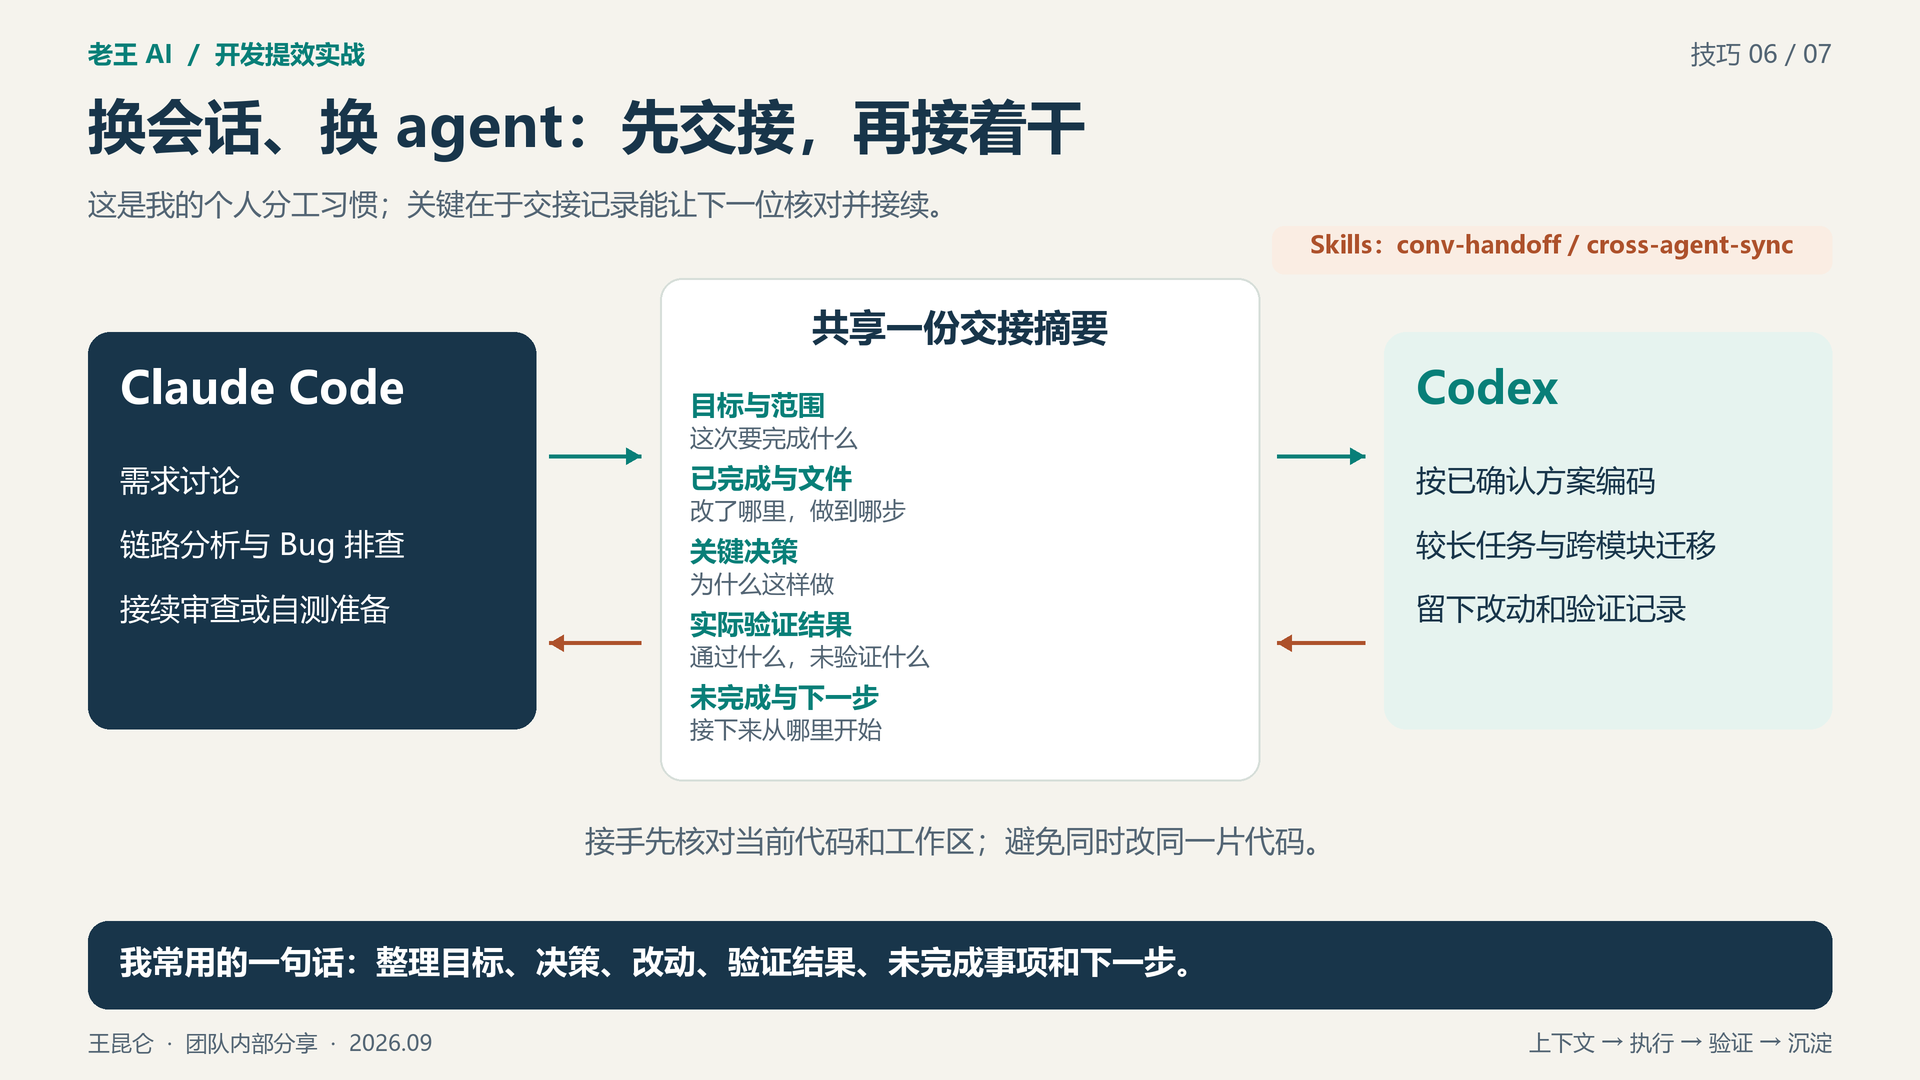
**讲解提示:**这是我自己的分工习惯。切换工具时,中间这份交接摘要最关键;接手方先核对当前代码与验证记录,再继续做。

对话 D6|交接时把未完成事项写明白(Claude Code,简化整理)
**我:**下个会话继续处理这项 Bug 排查。
**老王:**交接已整理:哪些已经完成、哪一处改了但还没编译、下一轮先做什么,以及还有哪些待验证项,都已写明。
**提效技巧:**交接要留下已做、未验、下一步,防止接手方把进度当结论。 来源
对应 Skill:conv-handoff → cross-agent-sync——先保存会话进度,跨工具时再同步上下文。
7. 我的 Skill 工作流:编号文档链
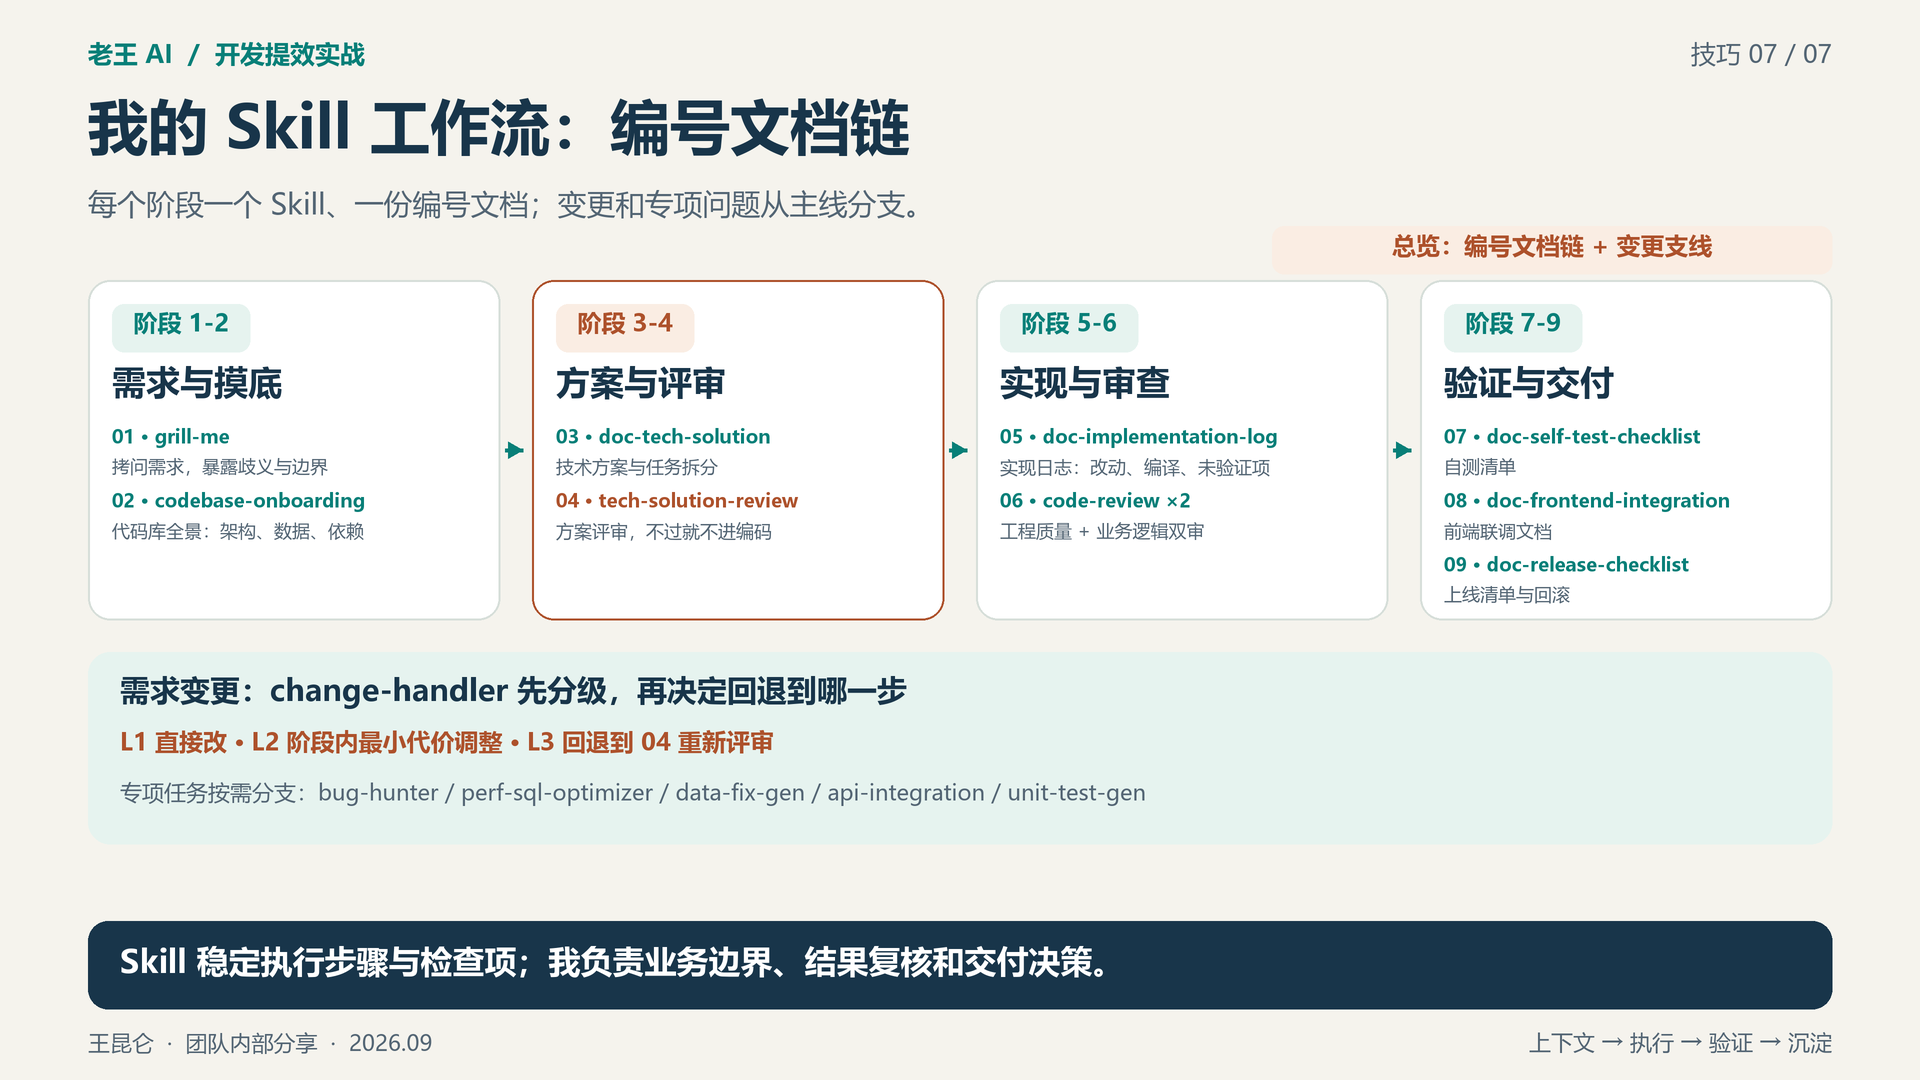
**讲解提示:**每个阶段一个 Skill、一份编号文档:01 需求拷问、02 代码库摸底、03 方案、04 评审、05 实现日志、06 代码审查、07-09 验证与交付。04 评审不通过就不进编码;需求中途变了走 change-handler 分级,Bug、慢 SQL、数据修复、三方对接再按需加载专项 Skill。

🏰 六、思考:AI 时代下开发人员的护城河
一句话:AI 越强,定义问题、组织上下文、设计验证、承担决策的价值越大。
| 护城河 | 要积累的能力 | 我的实践 |
|---|---|---|
| 🎯 问题定义权 | 知道业务要解决什么,识别错误前提与模糊边界 | 三方对接先核实允许的状态,再谈映射 |
| 🧠 隐性上下文 | 理解历史决策、业务例外和踩坑原因 | Memory、经验库、Bug 模式、真实 DDL 与接口资料 |
| ⚖️ 责任与决策权 | 判断方案取舍、上线时机、影响范围、回滚条件 | 方案人拍板,提交按授权,生产按流程复核 |
| ✅ 验证体系设计 | 把“应该没问题”变成可检查的条件和证据 | 编译检查、业务断言、三类证据交叉验证 |
| 🏗️ AI 生产体系 | 把一次有效协作变成可复用的流程 | 规则索引、专项 Skill、编号文档、跨 agent 交接 |
长期业务理解没法靠一份提示词复制,团队内该共享的就共享;个人价值在于能不能持续获取、判断和更新这些知识。
身份变化:从亲手写每一行代码,到组织实现并对业务结果负责。 对话 D3 里“调用方接口不改”的边界、D5 里“文档没有这个状态”的核对、方案评审结论的采纳,都是人的判断。
提效的目标不是产出更多内容,而是让正确交付更稳定、更可重复。这只是我当前阶段的用法,其他同事可能有更顺手的工具和提示方式,也欢迎交流。